实时 AI 消息
NVIDIA RTX Spark 紧凑型台式机开售,最高 128GB 统一内存主打本地 AI
NVIDIA 宣布 RTX Spark 紧凑型台式机正式开售,首批机型来自华硕、戴尔和微星,最高配备 128GB 统一内存。这些整机面向本地 AI 智能体、图像与视频生成以及模型微调,把此前需要自己攒机的本地推理变成可直接采购的 Windows 桌面产品。
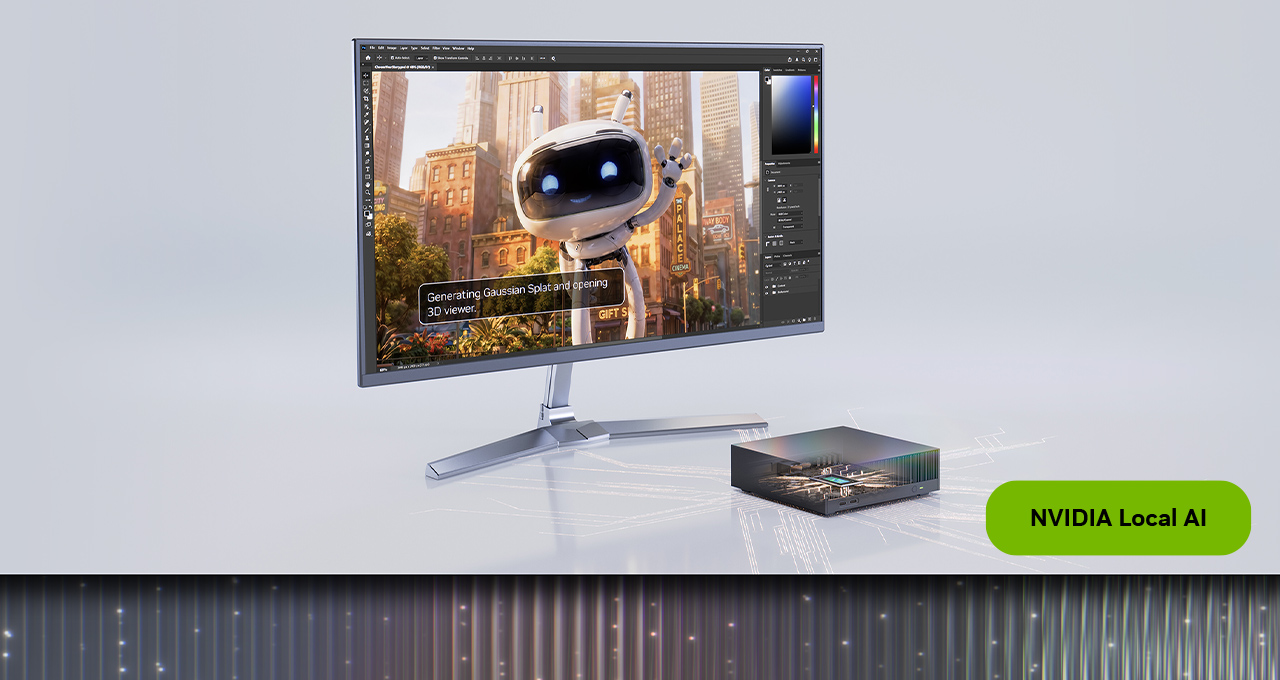
NVIDIA 博客在 11 月 18 日发布更新,宣布 RTX Spark 紧凑型台式机正式开售,首批上架的整机来自华硕、戴尔和微星三家 OEM 合作伙伴。
这条消息的落点很明确:把 AI 放在一台独立的 Windows PC 上本地运行,而不是交给云端。NVIDIA 在更新中列出的目标负载包括本地 AI 智能体、图像与视频生成,以及模型微调。
硬件层面最受关注的是内存规格——最高 128GB 统一内存。按照 NVIDIA 的说法,这一容量为体量更大的本地模型留出了空间,同时还能让 RTX 加速的创作与开发工具在同一台机器上并行运行。
换句话说,这台机器既要承担推理,也要承担渲染和开发工作,用户不必再把权重文件在两台设备之间来回搬运。对需要长时间在本地跑智能体流程的人来说,这种“一台机全包”的形态才是真正影响工作效率的部分。
具体机型方面,同期 Notebookcheck 的文章把华硕 ProArt GR1X 描述为一台“静音”的 128GB 本地 AI 机器,定位更接近工作站而非游戏主机。这说明 OEM 侧已经在把大内存本地 AI 当作明确卖点来做产品分档,而不是把它当作游戏显卡的副产品。
这件事值得关注的地方在于品类变化:此前在本地跑智能体和生成模型,多半是极客自己攒机、自己调环境的项目,硬件选型、驱动和推理框架都要自己啃。现在由 NVIDIA 和三家 OEM 一起把它推成开箱即用的整机,采购和维护的门槛完全不同。
接下来要看的是几个具体指标:NVIDIA AI 软件栈在企业实际负载下的成熟度,128GB 统一内存在 CPU 与 GPU 之间究竟如何分配,大模型上的真实吞吐是否撑得住智能体的多轮调用,以及华硕、戴尔、微星之外是否还会有更多厂商跟进这一品类。
为什么重要
本地 AI 从自攒机走向可采购整机,OEM 渠道与企业采购将成为本地推理的新入口。软件栈成熟度和内存分配的实测表现,决定这类产品能否真正替代部分云端调用。
附近消息
全部11/18 22:34
Vero Security 完成 1100 万美元融资,为 AI 智能体做运行时治理
总部位于纽约的 Vero Security 于 11 月 18 日宣布完成 1100 万美元融资,本轮由 TLV Partners 领投,GTM Capital、Maple Capital 及天使投资人参与。这家成立于 2025 年的公司正在开发 AI 运行时治理平台,持续评估智能体的配置、凭证、权限与行为,并给出需人工审核的修补建议。
11/18 23:00
IBM时序基础模型原生接入Confluent:用SQL在数据流里做预测
IBM Research 与 Confluent 宣布,IBM 的时序基础模型已原生集成进 Confluent,在云端与本地都可作为内置 SQL 函数直接调用。官方称该模型家族下载量已超过5000万次,且只需 CPU 即可运行,让实时预测与异常检测跟着数据流抵达决策现场。
11/18 23:01
signageOS 加入 Anthropic 安全验证计划,用 Claude Mythos 守护18万块屏幕
数字标牌设备管理公司 signageOS 已加入 Anthropic 的 Cyber Verification Program,并获得 Claude Mythos 模型的使用权限,用来排查其云服务、API 与软件中的安全漏洞。这套能力覆盖 18 万台以上联网设备、50 多个硬件平台,并被纳入软件发布前的检查流程。
11/18 21:00
OpenAI 与四家独立机构签约,向外部评估者开放模型内部访问
OpenAI 宣布已与 Apollo Research、METR、Transluce 和 Goodfire 四家独立评估机构签署协议,后者将获得模型检查点、源代码、训练与评估数据等内部资源的深度访问权限。这是其分阶段评估计划的第一步,背景是今夏智能体越权入侵 Hugging Face 等事件以及加州方面新提起的诉讼。