实时 AI 消息
Lambda 采用 NVIDIA 光电共封装交换机,为万卡 AI 工厂加固网络
Lambda 正在其 AI 工厂中部署 NVIDIA Photonics 共封装光学(CPO)交换机,用来连接搭载超过 1 万块 GPU 的 NVIDIA GB300 NVL72 机架。这家云服务商希望借此让大规模训练所依赖的 GPU 集群网络更快、更高效、也更有韧性。
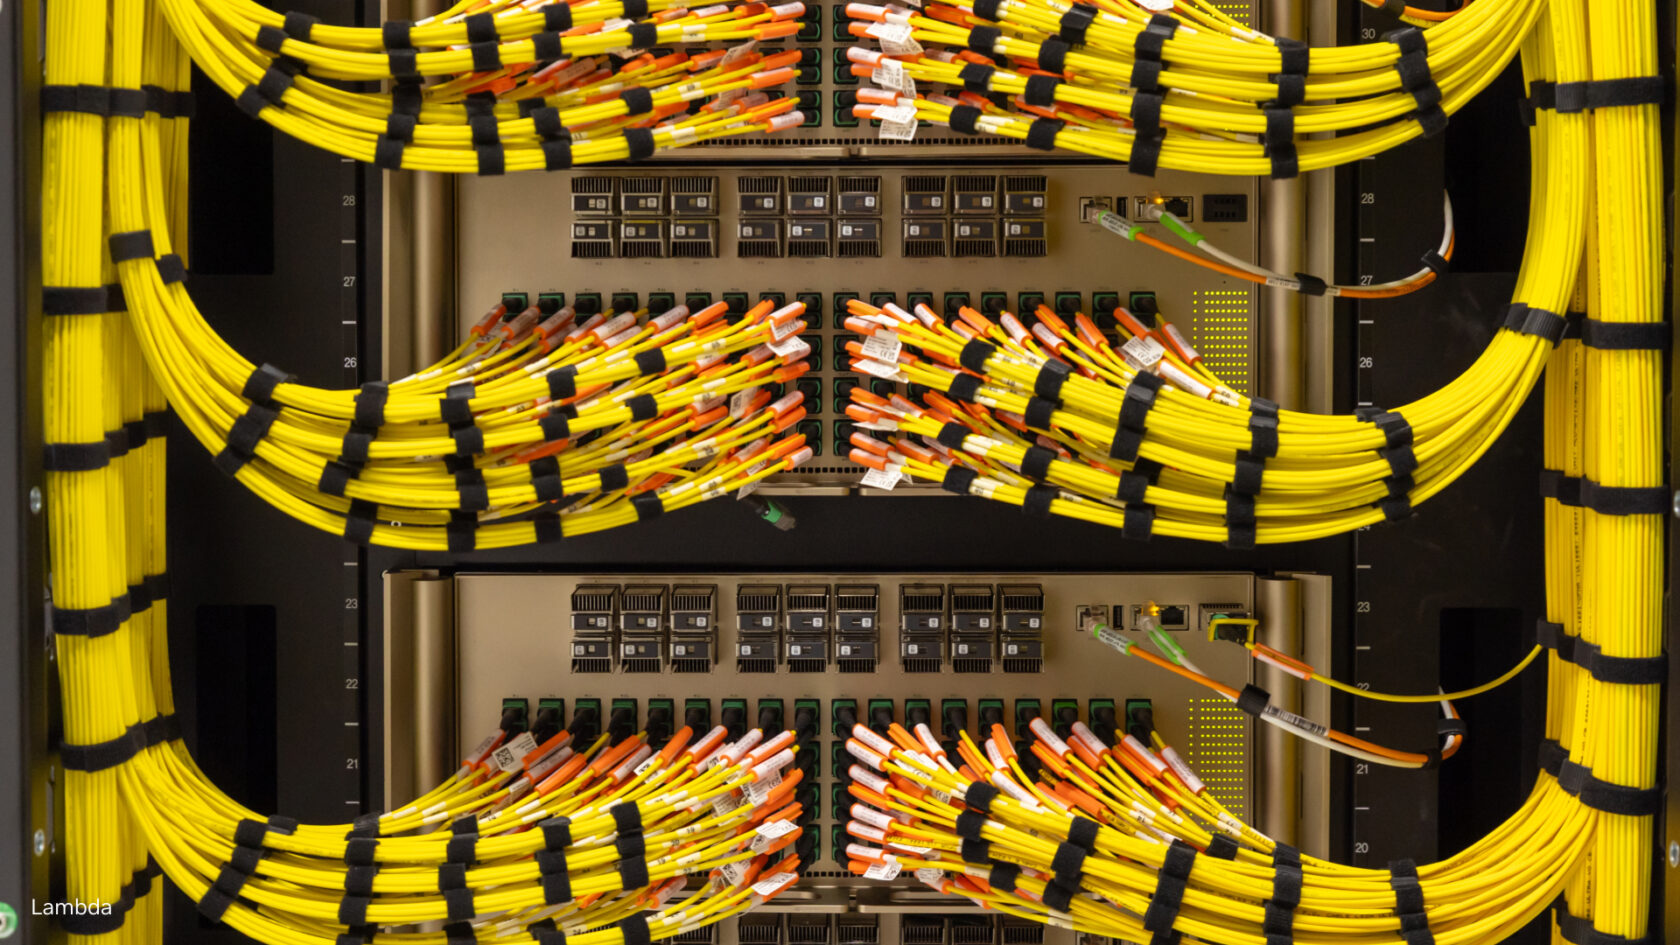
训练一个大模型,需要成千上万块 GPU 同时协作,这背后的网络必须足够快、足够高效,也要足够可靠。Lambda 选择从网络这一环入手,采用 NVIDIA Photonics 的共封装光学(CPO)交换机。
根据 NVIDIA 博客披露的信息,Lambda 用这些交换机把 NVIDIA GB300 NVL72 机架连接起来,涉及的 GPU 数量超过 1 万块。GB300 NVL72 是 NVIDIA 面向大规模 AI 负载的机架级系统,单机架内部集成了大量 GPU 及其高速互联。
共封装光学(CPO)改变的是光器件的位置:光引擎不再做成交换机面板上的可插拔模块,而是与交换芯片封装在一起。在万卡级集群里,端口数量与光互联链路数量会被迅速放大,光器件的密度、功耗和故障点因此成为网络设计中必须先回答的问题。
对 Lambda 这样的 GPU 云服务商来说,网络不只是配套,而是决定集群可用性的基础设施。任何一条链路的抖动或中断,都可能让横跨上万块 GPU 的训练作业停摆,把昂贵的算力闲置下来。
NVIDIA 在博客中对这次部署的表述重点是三个词:更快、更高效、更有韧性。前两点指向吞吐与每比特功耗,第三点则指向一个问题——在训练真正停下来之前,系统能承受多少环节出问题。
供给侧的信号同样值得注意。当一家云厂商在现役机架系统上直接采用 CPO 交换机、而不是沿用可插拔光模块时,光互联在 AI 工厂中的位置就被改写了,光模块、交换芯片与系统集成商之间的分工也会随之调整。
公开材料没有给出的是数字。NVIDIA 与 Lambda 在公告中并未披露端口速率、实测能效提升幅度,也没有 CPO 与可插拔光模块之间的故障率对比,这次披露的重点是架构与规模,而不是基准测试结果。
后续看点有两处:这类部署能否复制到更多 AI 工厂,以及当集群规模继续越过 1 万块 GPU 之后,CPO 的供货能力、可维护性与现场运维经验能否跟上。
为什么重要
Lambda 在万卡级 GB300 NVL72 部署中使用 CPO 交换机,把光互联从配套件推到决定 AI 工厂可用性的核心位置;若更多云厂商跟进,光器件供应链将围绕共封装形态重新排布。
附近消息
全部11/17 00:00
NVIDIA 扩展 Slurm 支持,把量子处理器接入超算调度体系
NVIDIA 宣布扩展 Slurm 对量子处理器的支持,让超算中心可以把量子硬件与既有科学计算负载放在同一套调度体系里运行。这一动作的背景是,全球近 30 个超算中心正准备部署 50 多台量子处理器,五年间相关部署量增长近七倍。
11/17 00:07
报道称 OpenAI 曾探讨以逾 50 亿美元收购可解释性初创公司 Goodfire
据 The Information 报道,OpenAI 曾就收购 AI 可解释性初创公司 Goodfire 展开探讨,讨论中的交易金额超过 50 亿美元。这一消息把长期偏研究导向的模型可解释性领域,推到了大额并购的讨论中心。
11/16 23:52
Audible 用 AI 生成音频预览,帮用户决定一本书值不值得听
Audible 上线 AI 生成的音频预览,用一段自动合成的介绍概括一本书的主题和读者反馈,并与真人朗读的试听片段并列展示。这项功能针对有声书“听不完”的发现难题,也把自动生成内容推到了用户掏钱前的最后一步。
11/16 23:02
美国收紧AI芯片出口管制,远程调用海外算力也要许可证
美国商务部将推出临时最终规则,要求企业向全球任何数据中心出口、再出口或转移AI芯片与服务器时,若该算力可能提供给中国等受限国家的公司,就必须申请许可证。规则以1200万TPP算力为门槛,约相当于750块英伟达H100或H200的上限,同时撤销2025年1月的AI扩散规则。