实时 AI 消息
NVIDIA 扩展 Slurm 支持,把量子处理器接入超算调度体系
NVIDIA 宣布扩展 Slurm 对量子处理器的支持,让超算中心可以把量子硬件与既有科学计算负载放在同一套调度体系里运行。这一动作的背景是,全球近 30 个超算中心正准备部署 50 多台量子处理器,五年间相关部署量增长近七倍。
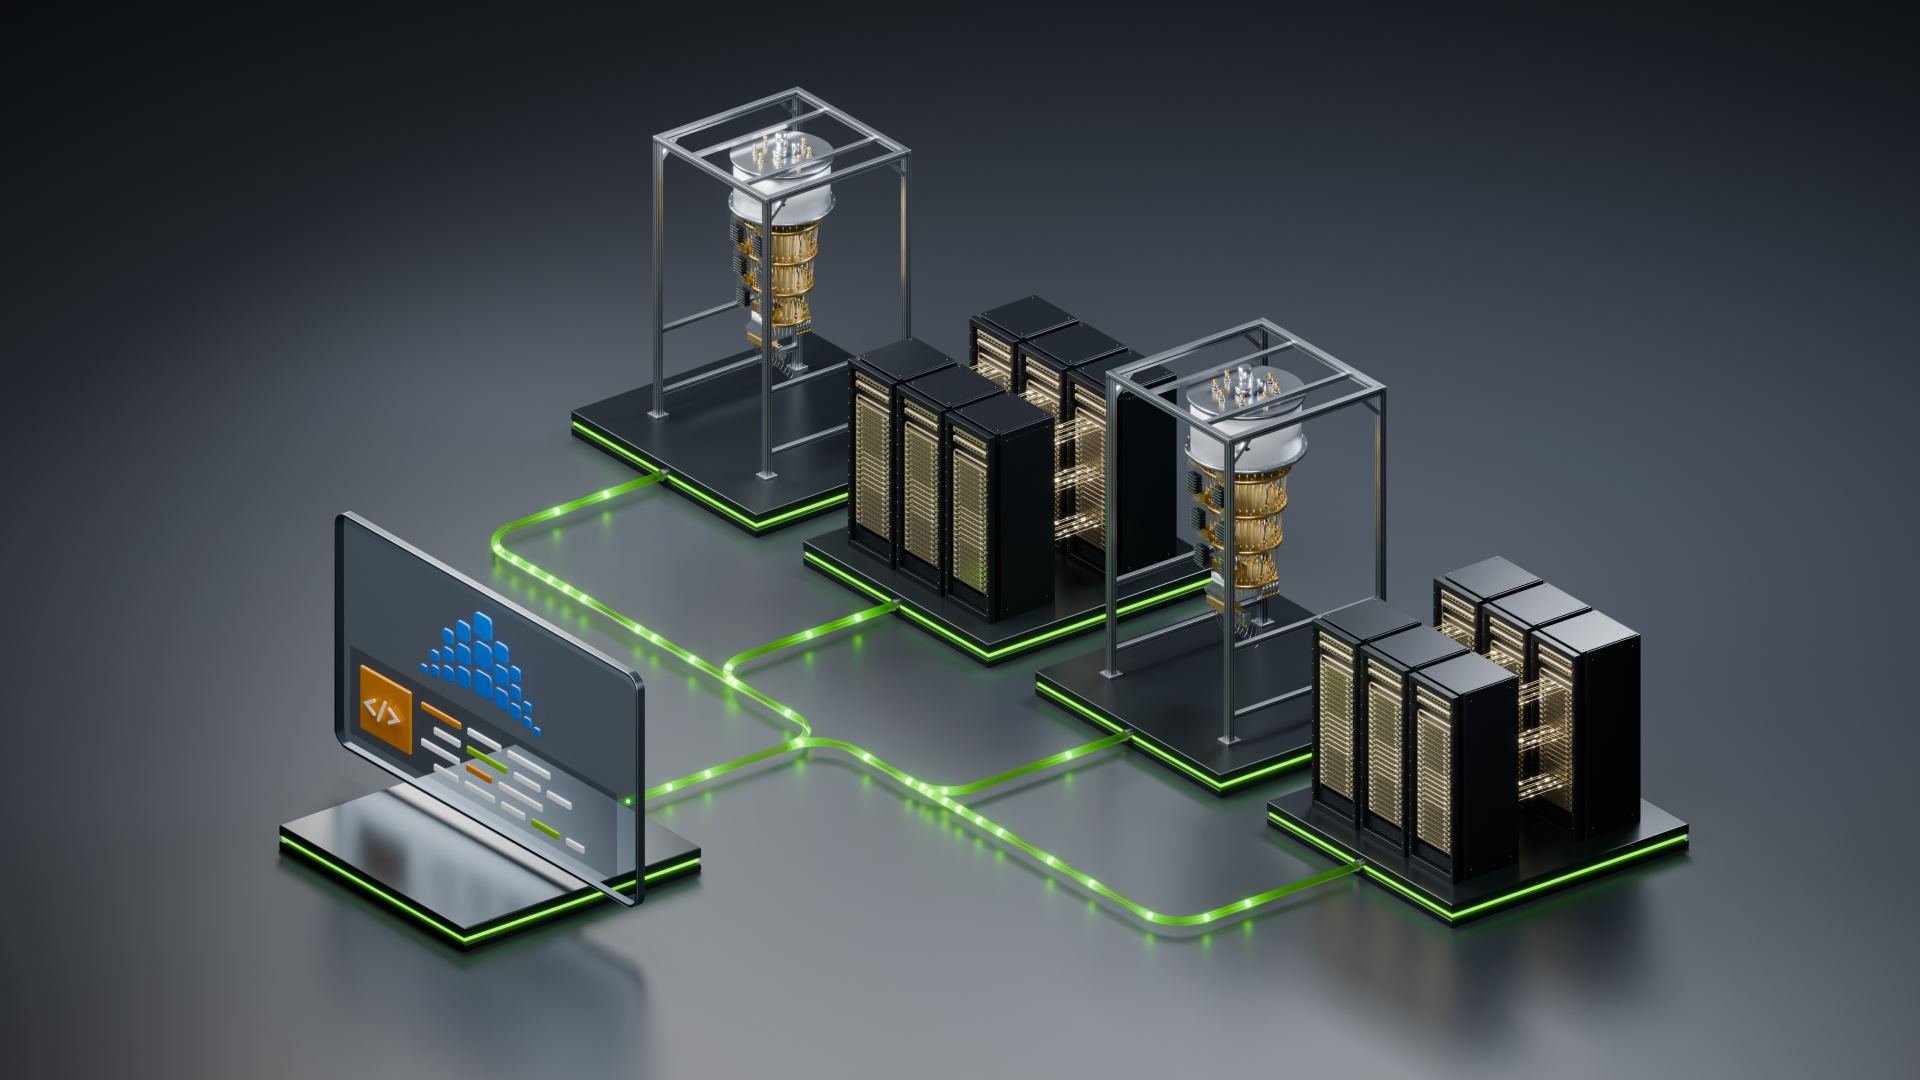
NVIDIA 在博客中宣布,将扩展 Slurm 对量子处理器的支持,让量子硬件进入超算中心既有的作业调度体系。
NVIDIA 给出的背景数字是:过去五年,超算中心的量子处理器部署量增长近七倍;目前全球近 30 个超算中心正在部署 50 多台量子处理器。
Slurm 决定哪个作业在什么时间跑在哪类硬件上。这些超算中心本来就用它管理经典科学计算负载,把量子处理器纳入支持范围,意味着量子硬件可以和既有资源在同一套系统里申请、排队和调度,而不必另建一套调度栈。
这正是公告里的实用逻辑。新型加速器通常自带工具链、自带调度习惯,也自带运维负担;把它接进运维团队已经在跑的那套调度器,能显著降低“试一试”的门槛。
这也符合量子计算在当前技术栈中的定位:它不是替代超算的独立机器,而是一种被按需调用的专用资源,由 GPU 与 CPU 承担其余工作。
公告没有展开的是生态细节。支持哪些厂商的量子处理器、编程接口是什么形态、这一能力何时普遍可用,公开摘要中都没有给出。
从绝对规模看,30 个中心、50 多台处理器仍是研究级体量,而不是生产级机群。这也解释了为什么在这一阶段,调度层的打通比算力总量更值得关注。
下一步要看的,是混合了量子与经典资源的作业能否变得足够常规,让研究者不再把量子当作一次单独的实验;以及 Slurm 的量子支持能否跟上各家正在公布的硬件路线图。
为什么重要
把量子处理器接入超算中心已在运行的调度器,降低的是尝试量子硬件的运维成本;在当前部署规模仍属研究级的阶段,这一点比处理器数量本身更能影响采用速度。
附近消息
全部11/17 00:00
Lambda 采用 NVIDIA 光电共封装交换机,为万卡 AI 工厂加固网络
Lambda 正在其 AI 工厂中部署 NVIDIA Photonics 共封装光学(CPO)交换机,用来连接搭载超过 1 万块 GPU 的 NVIDIA GB300 NVL72 机架。这家云服务商希望借此让大规模训练所依赖的 GPU 集群网络更快、更高效、也更有韧性。
11/17 00:07
报道称 OpenAI 曾探讨以逾 50 亿美元收购可解释性初创公司 Goodfire
据 The Information 报道,OpenAI 曾就收购 AI 可解释性初创公司 Goodfire 展开探讨,讨论中的交易金额超过 50 亿美元。这一消息把长期偏研究导向的模型可解释性领域,推到了大额并购的讨论中心。
11/16 23:52
Audible 用 AI 生成音频预览,帮用户决定一本书值不值得听
Audible 上线 AI 生成的音频预览,用一段自动合成的介绍概括一本书的主题和读者反馈,并与真人朗读的试听片段并列展示。这项功能针对有声书“听不完”的发现难题,也把自动生成内容推到了用户掏钱前的最后一步。
11/16 23:02
美国收紧AI芯片出口管制,远程调用海外算力也要许可证
美国商务部将推出临时最终规则,要求企业向全球任何数据中心出口、再出口或转移AI芯片与服务器时,若该算力可能提供给中国等受限国家的公司,就必须申请许可证。规则以1200万TPP算力为门槛,约相当于750块英伟达H100或H200的上限,同时撤销2025年1月的AI扩散规则。