戴上这副AI眼镜,外国人的话直接变成眼前的字幕,太夯了!
你好,我是郭震!
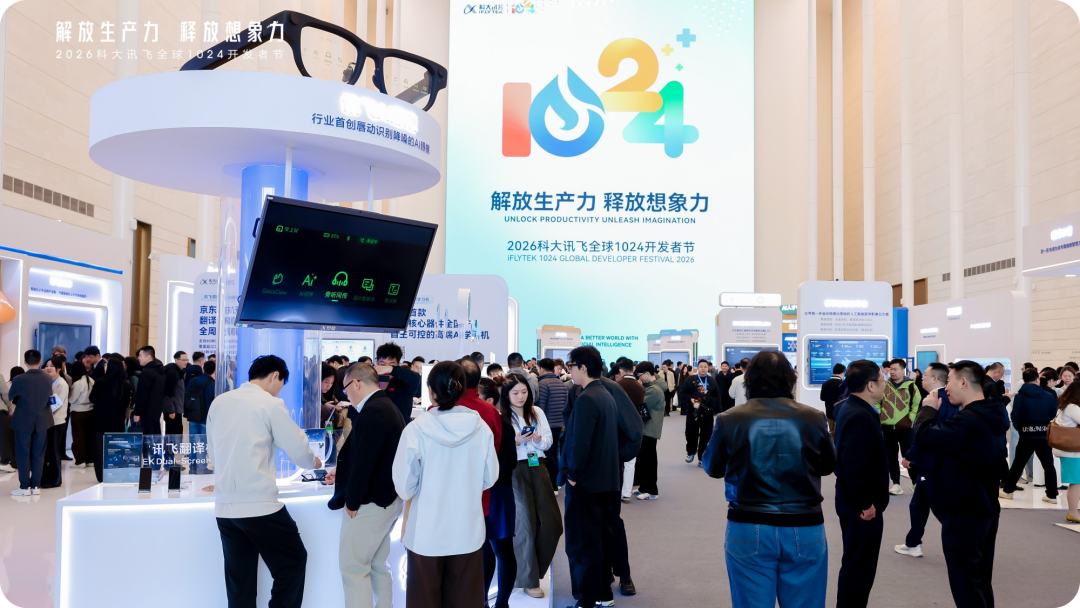
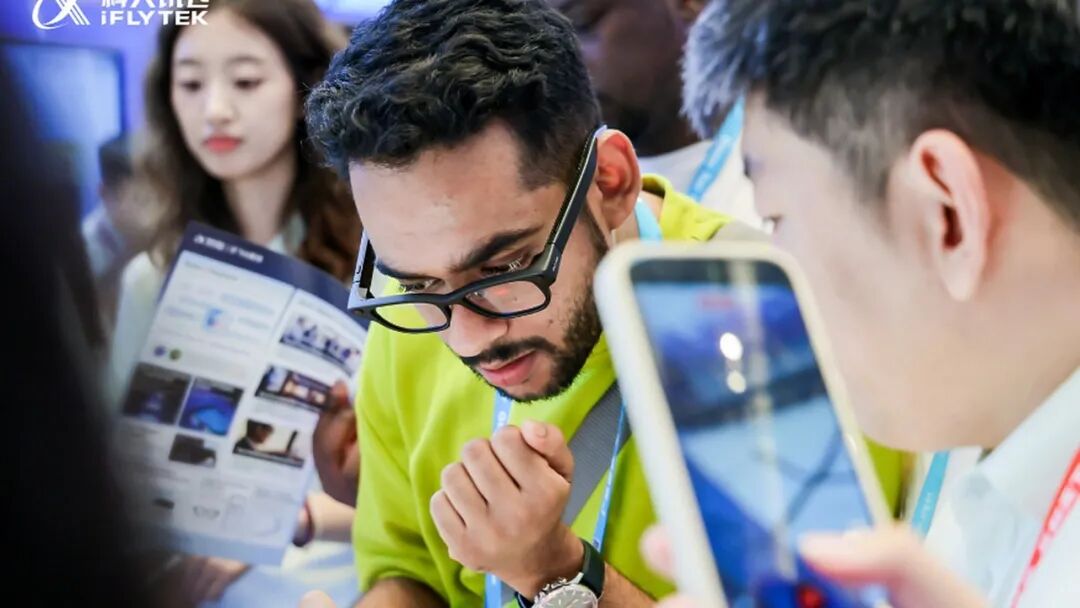
这几天看 2026 科大讯飞全球 1024 开发者节的现场画面,讯飞 AI 眼镜的展位让我印象很深。
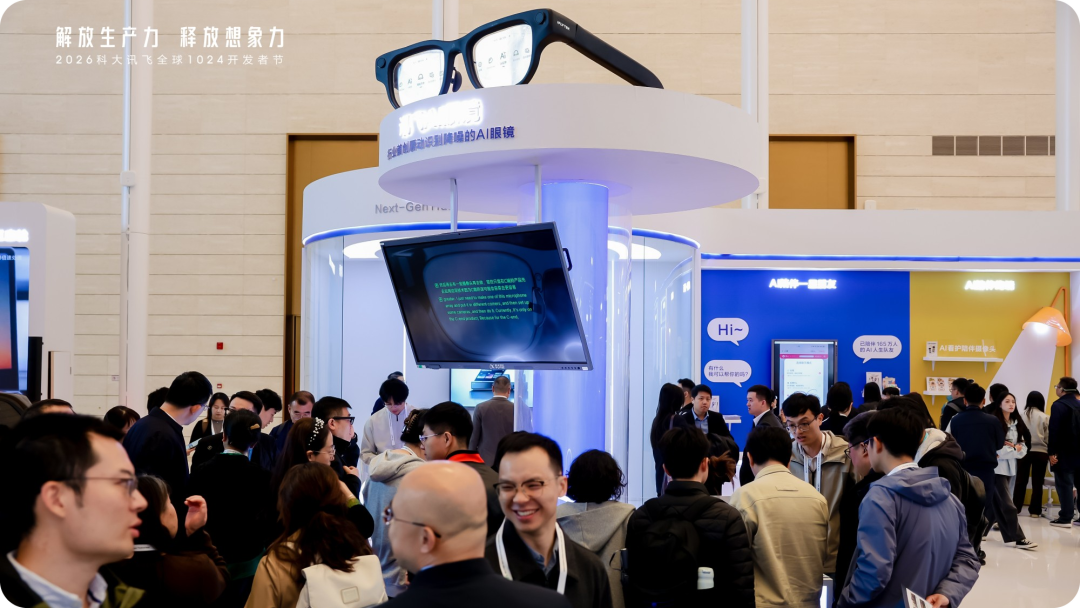
展馆里人声鼎沸,按理说是翻译设备最难发挥的环境,讯飞 AI 眼镜的展位前却排起了长队,不少人就想在这种环境里试试它到底能不能听清。来自中东、欧洲等地区的媒体和客商轮流上前试戴。
最让我印象深刻的一幕,是央视新闻记者和一位精通六种语言的讯飞语言专家在现场对话:对方刚一开口,翻译字幕就浮现在镜片上。两人全程看着彼此交流,不用低头看屏幕,也不用把手机递来递去。
如下图所示,为1024开发者节的展馆现场:
作为一个天天和AI打交道的人,我更关心的是背后的技术问题:一副看起来和普通眼镜差不多的设备,是怎么在嘈杂的展馆里听清对方、听懂外语,再把结果放到你眼前的?
于是,我把市面上能找到的公开资料仔细拆了一遍,整理成这篇笔记,感兴趣的可以看看。
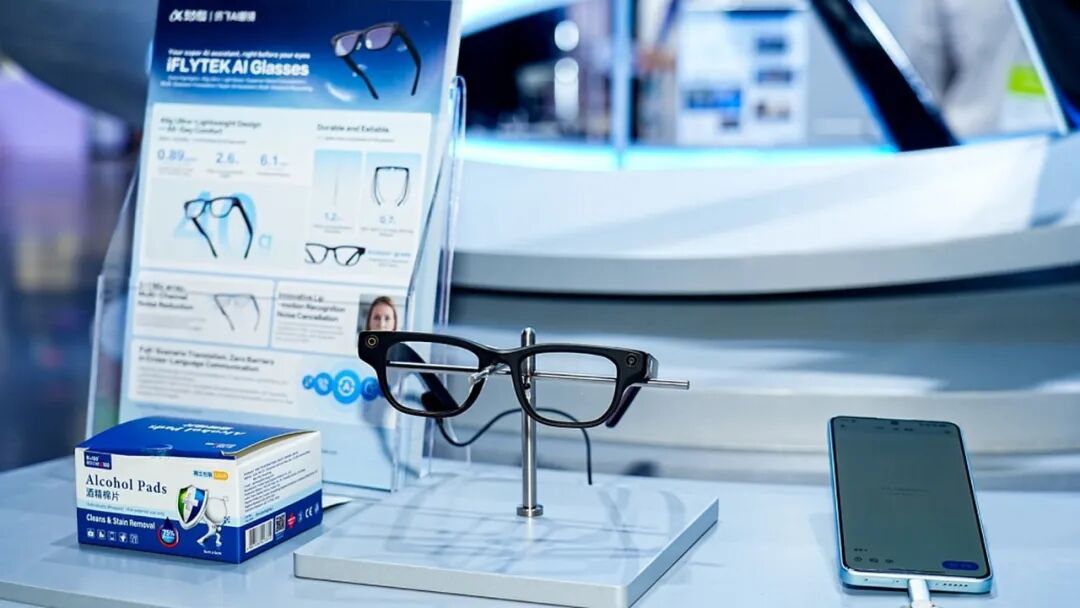
如下图所示,为讯飞AI眼镜的产品外观:
1 用户为什么需要一副AI眼镜?
先说一个问题:AI眼镜这两年很热,但很多人戴过之后的第一反应是,好像也没什么非用不可的理由。
回头看,2012 年问世的 Google Glass(谷歌眼镜),第一次把数字信息搬进了人的视野。可惜它受困于价格高、续航短,以及摄像头引发的隐私争议,最终没能走进普通人的日常生活。
说到底,那时的眼镜只是一块戴在脸上的小屏幕:能显示信息,却听不懂人话,也看不懂眼前的画面。
但只有能力还不够,用户需要一个具体的、天天都会碰到的痛点。讯飞给出的答案是跨语言沟通。
如下图所示,为展会现场排队试戴讯飞AI眼镜的客商:
我把跨语言沟通拆了一下,现场其实有三重负担:听不清、听不懂、总低头。巧的是,这三重负担,正好对应AI眼镜要过的三道技术关。
如下图所示,一张图看懂三重负担和三道技术关的对应关系:
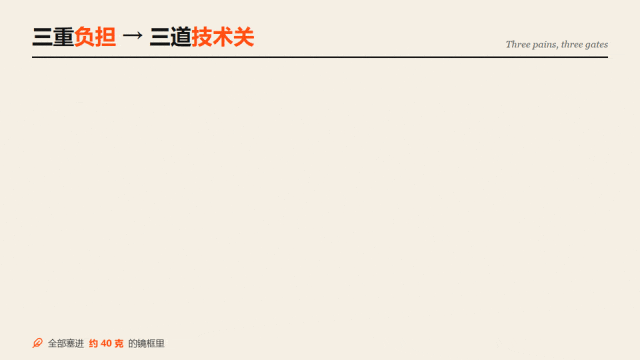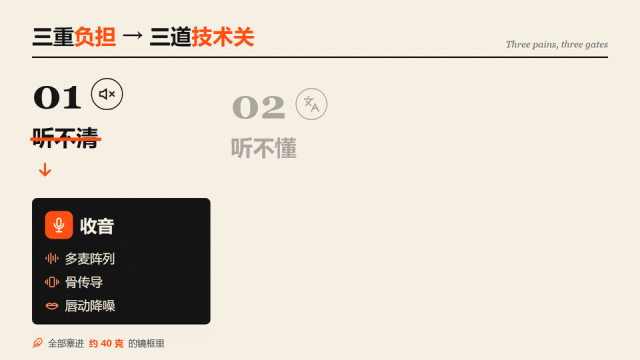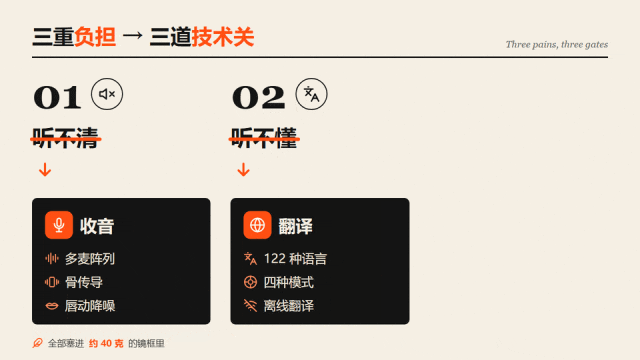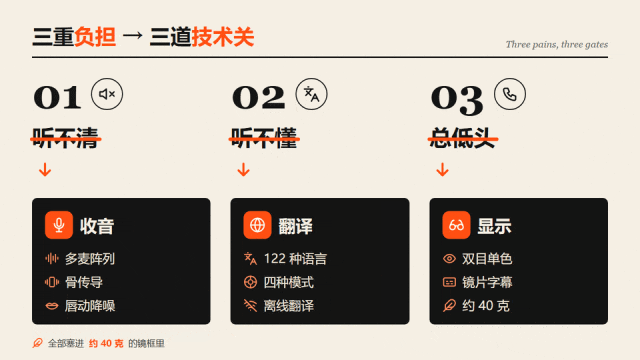
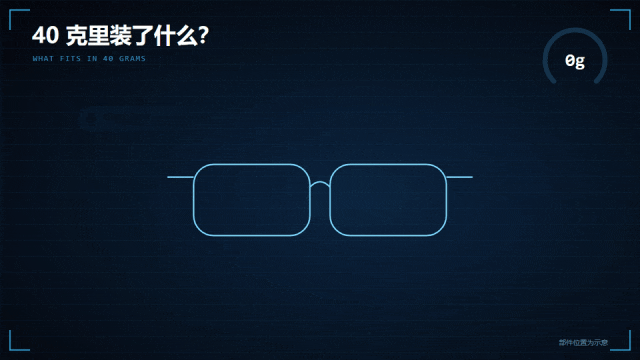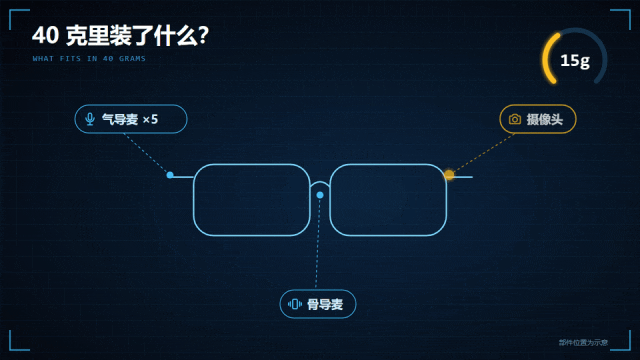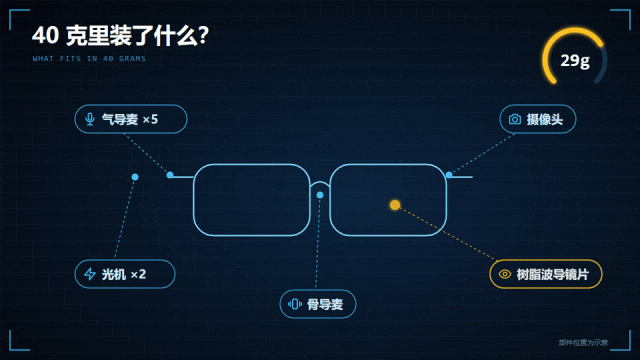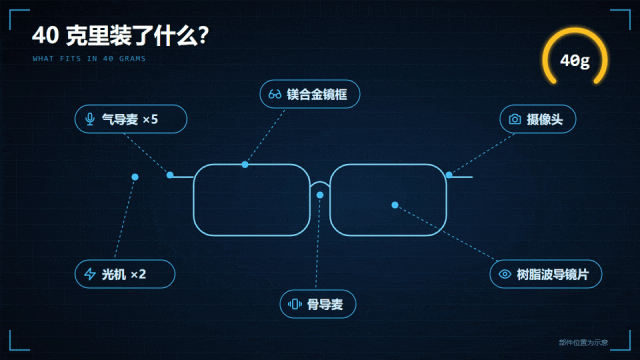
更难的是,这三道关都要塞进一副约40克的镜框里,重量、功耗、算力处处都要取舍。下面一关一关拆。
2 第一关:听不清,用视觉帮耳朵锁定说话人
很多人以为翻译的核心是翻译模型,其实第一道坎在收音。
展会、会场、街头都很嘈杂,收进来的声音一旦混进别人的说话声和背景噪声,后面的识别和翻译再强也会出错。说白了,拾得准,结果才准。
讯飞AI眼镜在硬件上用的是多麦克风阵列加骨传导:5颗气导麦克风负责收空气中的声音,1颗骨传导麦克风采集佩戴者说话时的骨骼振动。
如下图所示,为讯飞AI眼镜的5+1麦克风阵列:
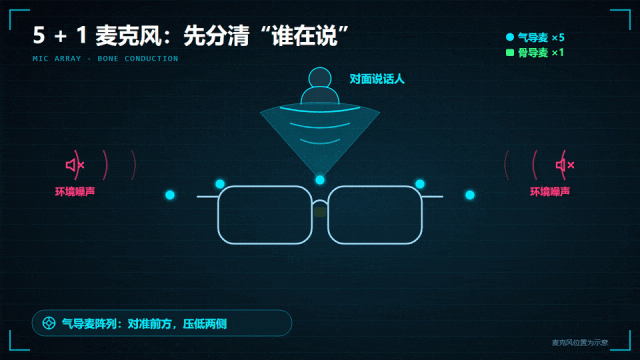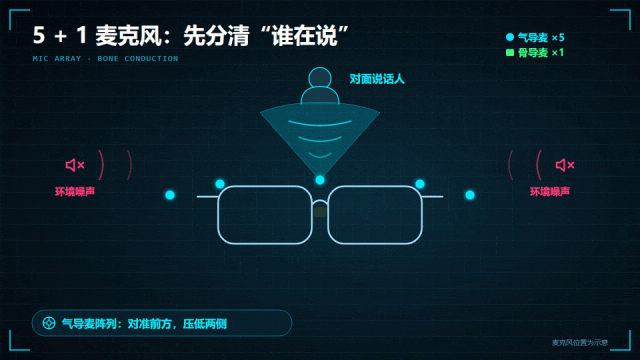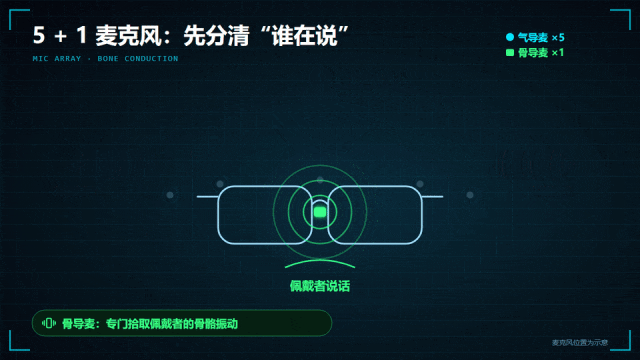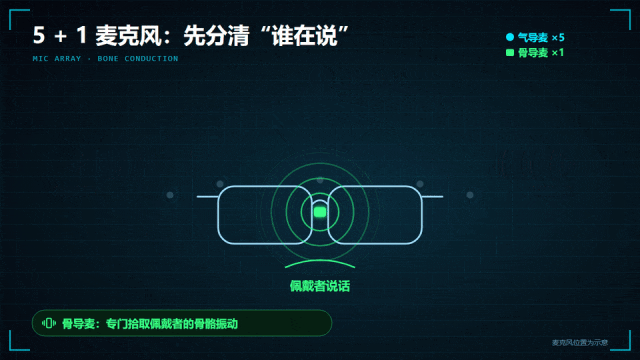
骨传导这一路很关键。它只对佩戴者自己的声音有反应,系统就能用它把“我说的”和“别人说的”区分开,这在通话和面对面交流时特别有用。
更有意思的是第三路输入:摄像头。
讯飞在面对面翻译场景里加入了唇动识别降噪。摄像头追踪对面说话人的唇部关键点,再和麦克风收到的音频特征一起分析,谁的嘴在动、和哪段声音对得上,就锁定谁。
如下图所示,这是唇动识别降噪的示意:
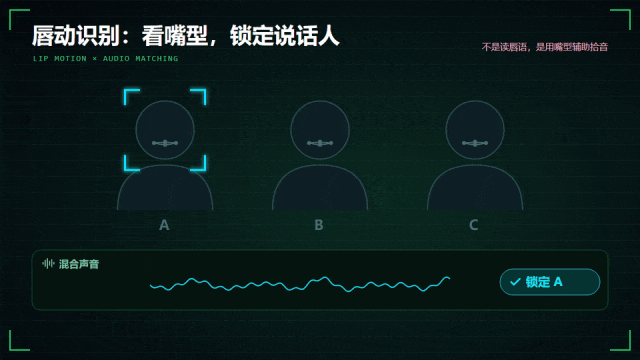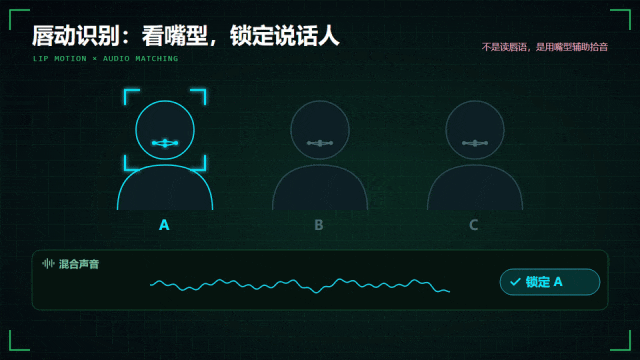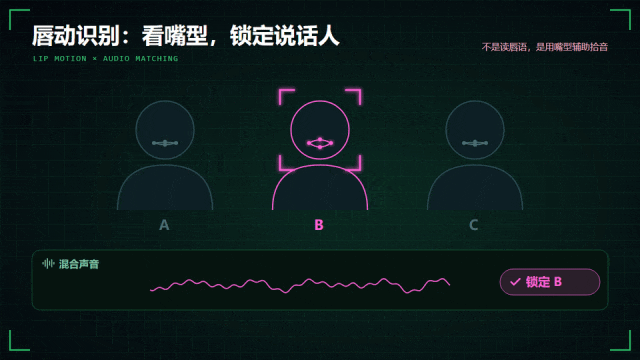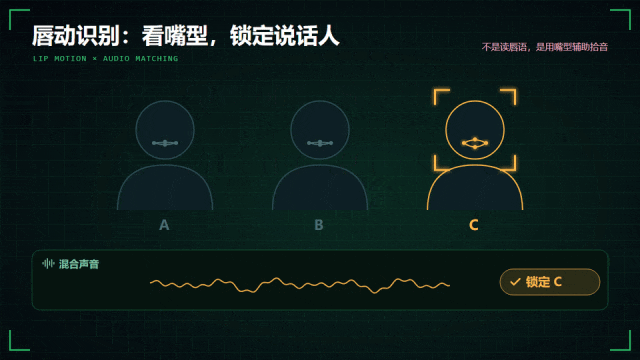
这里要特别说明:唇动识别降噪不是读唇语,而是用视觉信息辅助拾音,帮助系统在多人交流和嘈杂环境里锁定目标说话者、抑制背景噪声。简单说,就是看谁就翻谁。
如下图所示,这是完整的收音链路,三路信号汇入融合模块,输出干净的目标人声:
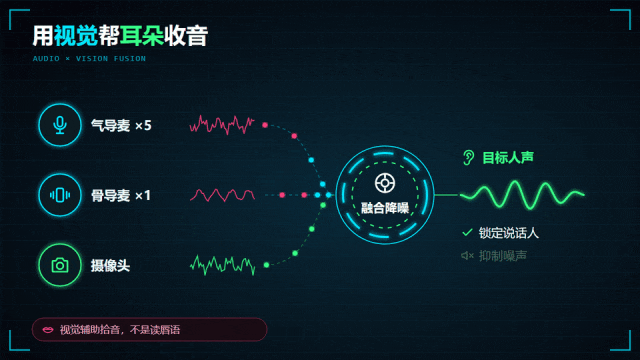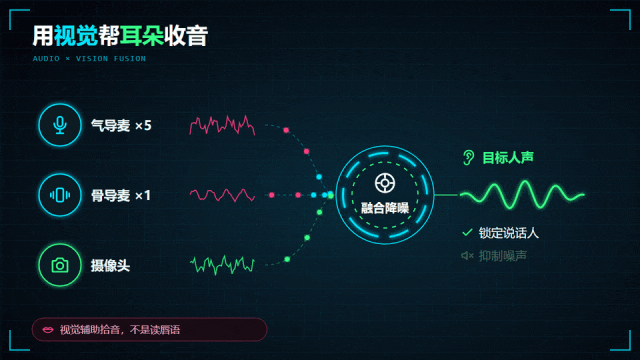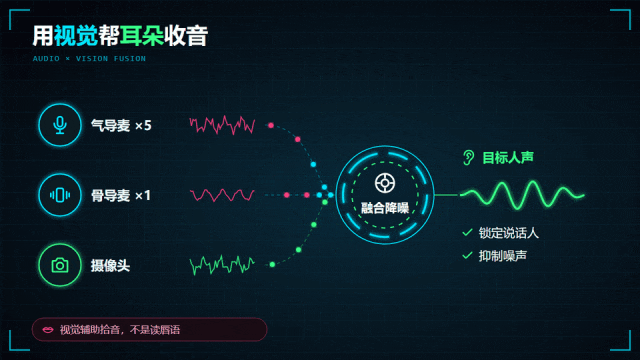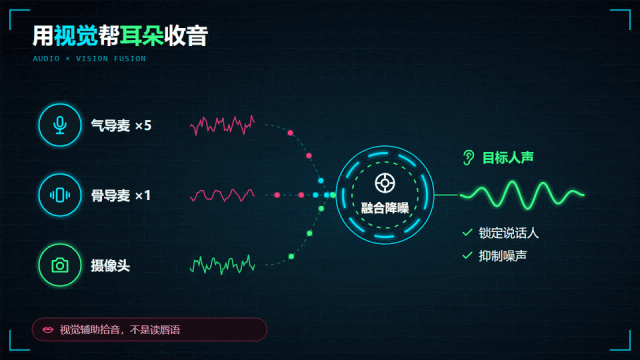
一句话总结:让摄像头为耳朵服务,本质上是一次多模态融合。
这一步,正是讯飞把二十多年语音技术积累迁移到眼镜形态上的关键。
3 第二关:听不懂,四种翻译模式是四套技术方案
声音收干净了,下一步是识别和翻译。
讯飞AI眼镜支持122种语言(含方言、口音)翻译,覆盖四种模式:旁听同传、面对面翻译、线上同传和通话翻译,分别对应会议旁听、商务洽谈和旅行交流、远程沟通、跨语言打电话这些场景。
如下图所示,为四大语音翻译模式:
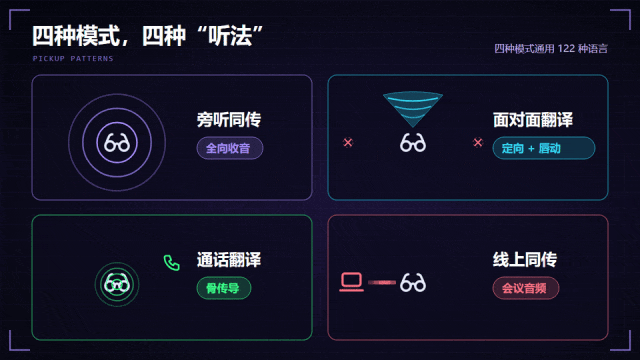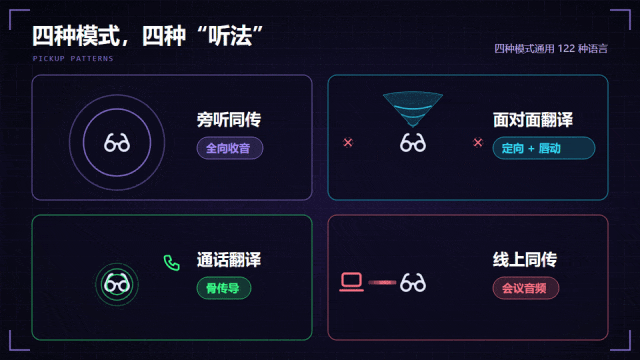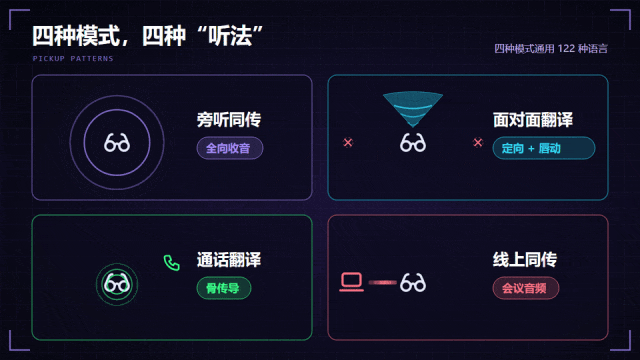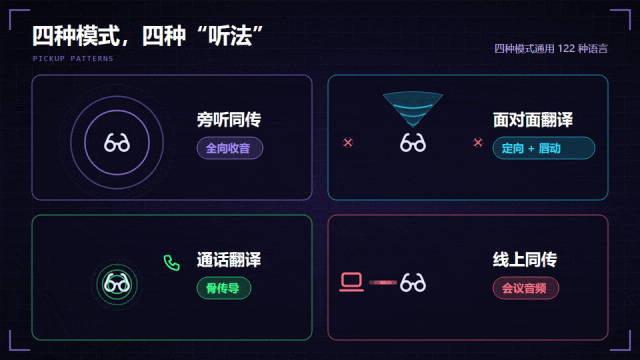
细看会发现一个细节:这四种模式并不是同一套能力换了四个入口,而是针对不同场景分别设计了收音策略。
旁听同传用全向收音,要完整捕获会场语音,长时间连续地边听边译。
面对面翻译用定向收音,只锁定眼前的对话人,还要在两种语言之间来回切换。通话翻译借助骨传导拾取佩戴者自己的声音,译文还可以用提前录好的克隆音色播报。
如下图所示,四种模式的技术差异对比:
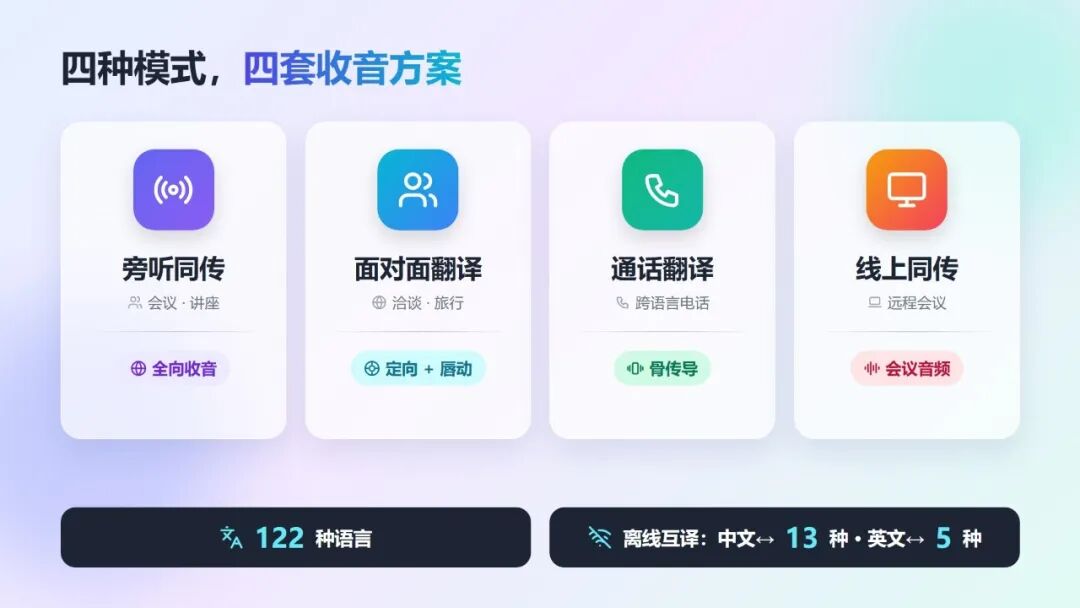
另外还有一个很实用的端侧能力:面对面翻译支持离线运行,中文可以和英语、日语、韩语、法语、西班牙语等13种外语离线互译,英语也能和5种外语离线互译。出国旅行时网络不稳定,这一点非常关键。
针对专业场景,眼镜还提供了医疗、金融、法律、外贸等行业翻译模式,以及自定义词库,可以把容易翻错的专有名词提前录进去。
同样是“能翻译”,背后是针对不同场景分别做的收音和识别方案。这正是讯飞多年做翻译机积累下来的工程经验,不是简单接一个翻译接口就能做出来的。
4 第三关:总低头,双目单色和40克是一次工程取舍
听清、听懂之后,还要把结果放到用户眼前。
用手机或翻译机时,人要反复掏出设备、低头看屏幕,对话中的目光交流一次次被打断。跨语言交流本来就费劲,再少了眼神和表情,沟通效果会大打折扣。
讯飞AI眼镜的做法是把翻译字幕直接呈现在镜片上。用户可以一边看译文,一边看对方的表情,信息获取和目光沟通两不耽误。
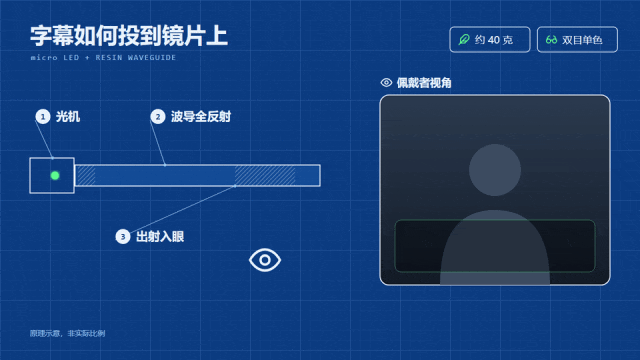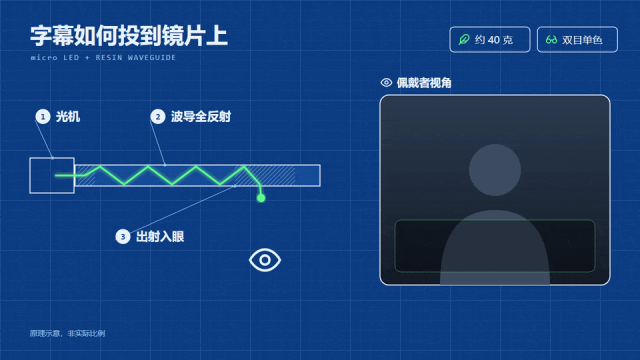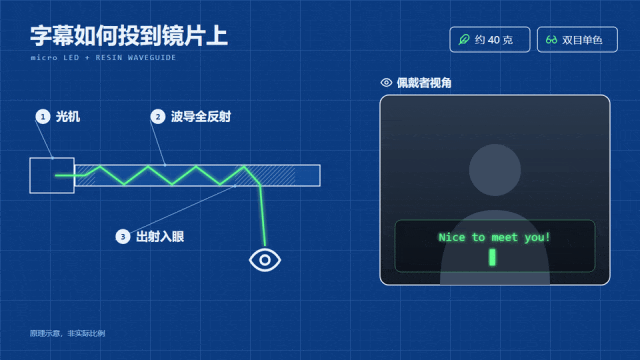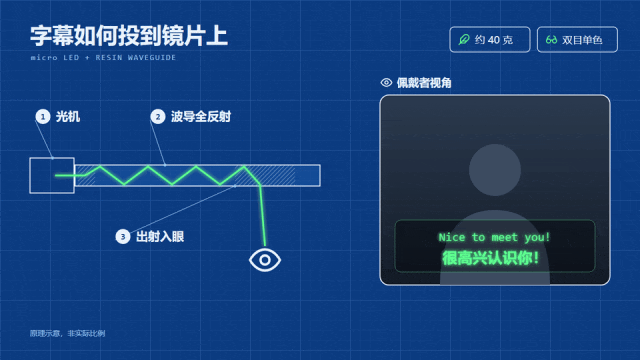
从技术上看,它采用双目单色显示:用micro LED(微型发光二极管)双光机做光源,再通过全贴合树脂波导把光导到镜片上,用户看到的是浮在视野里的绿色文字。
如下图所示,字幕从光机发出,在镜片里来回反射,最后从镜片中部射进人眼:
如下图所示,为产品的整机结构:
为什么不做彩色?我的理解是,这是一次很清醒的取舍。
全彩显示的光机更复杂,功耗、发热和重量都更难控制。而翻译字幕只需要文字,单色已经足够清晰。把重量和功耗省下来,留给收音、计算和续航。
结果就是整机约40克。据讯飞官方介绍,这是目前同类双目单色显示智能眼镜里最轻的一档,外观也接近普通眼镜,近视用户还可以定制度数镜片。
如下图所示,为客商现场试戴讯飞AI眼镜:
AI硬件最容易犯的错,是什么都想加。讯飞这次的克制反而说明,它很清楚用户是谁、要解决什么问题。
5 技术底座:眼镜是讯飞AI主线离人最近的落点
拆完三道关,再回到1024开发者节的整体技术主线看,会更清楚讯飞为什么要做眼镜。
今年1024,讯飞围绕三个问题展开:大模型怎样兼顾安全和性价比,AI怎样从数字世界走进物理世界,AI怎样从个人提效走向组织提效。
在人机交互上,讯飞的路线是“语音交互—多模交互—具身多模交互”。眼镜正好处在第二阶段,是最贴身的多模交互终端,和智能座舱、机器人共用一套听清、看懂的能力。
如下图所示,眼镜在讯飞技术主线上的位置:
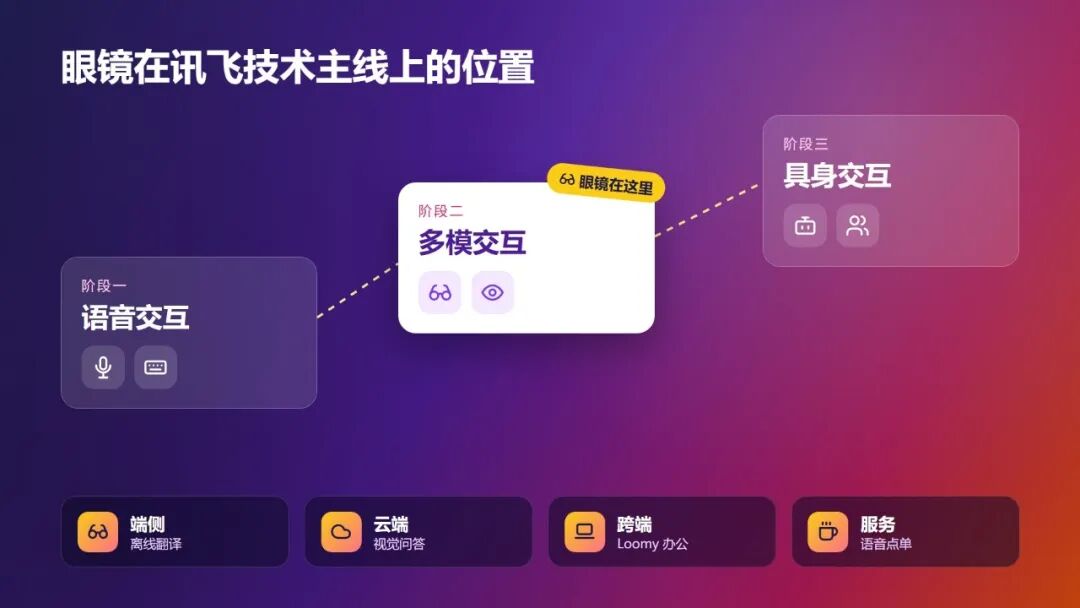
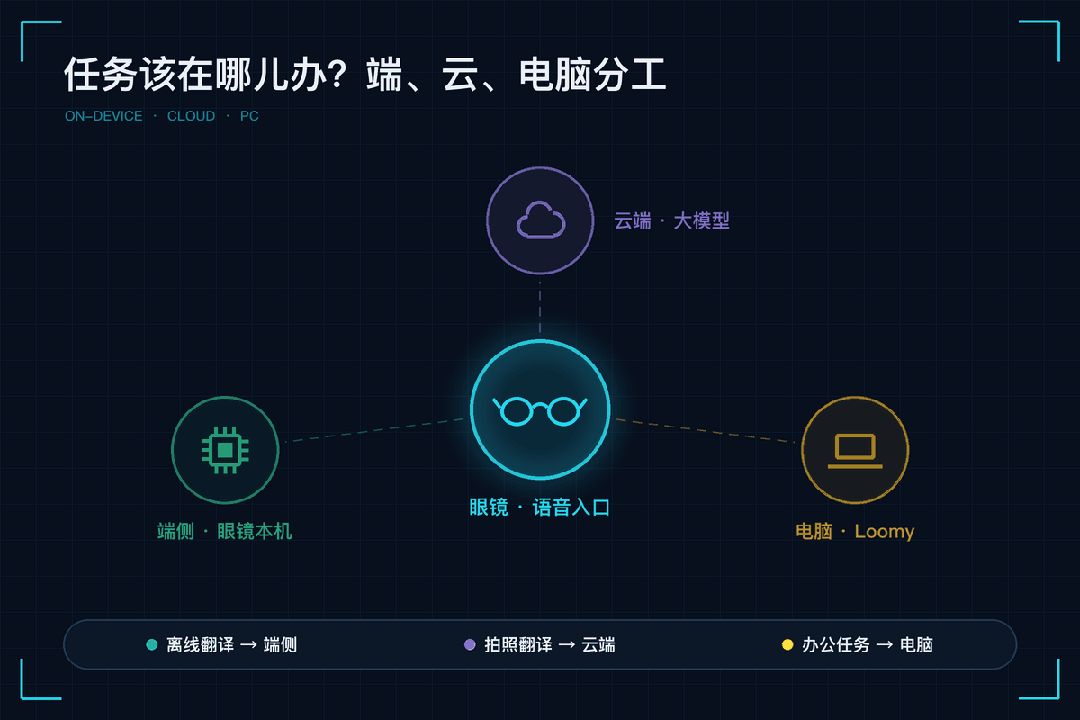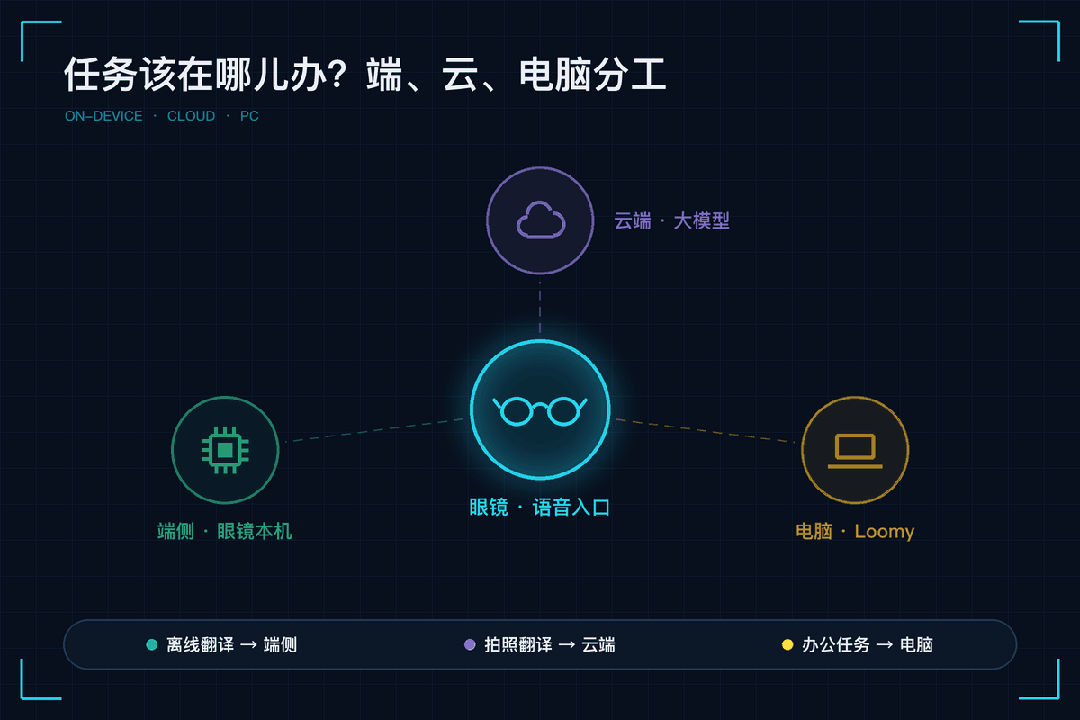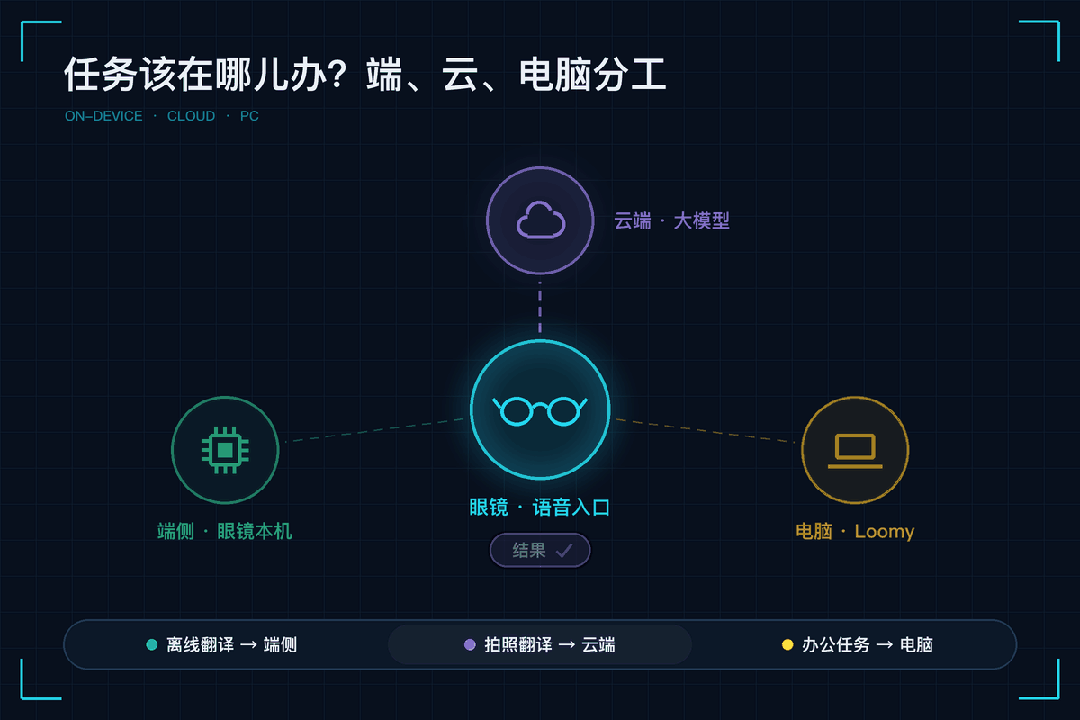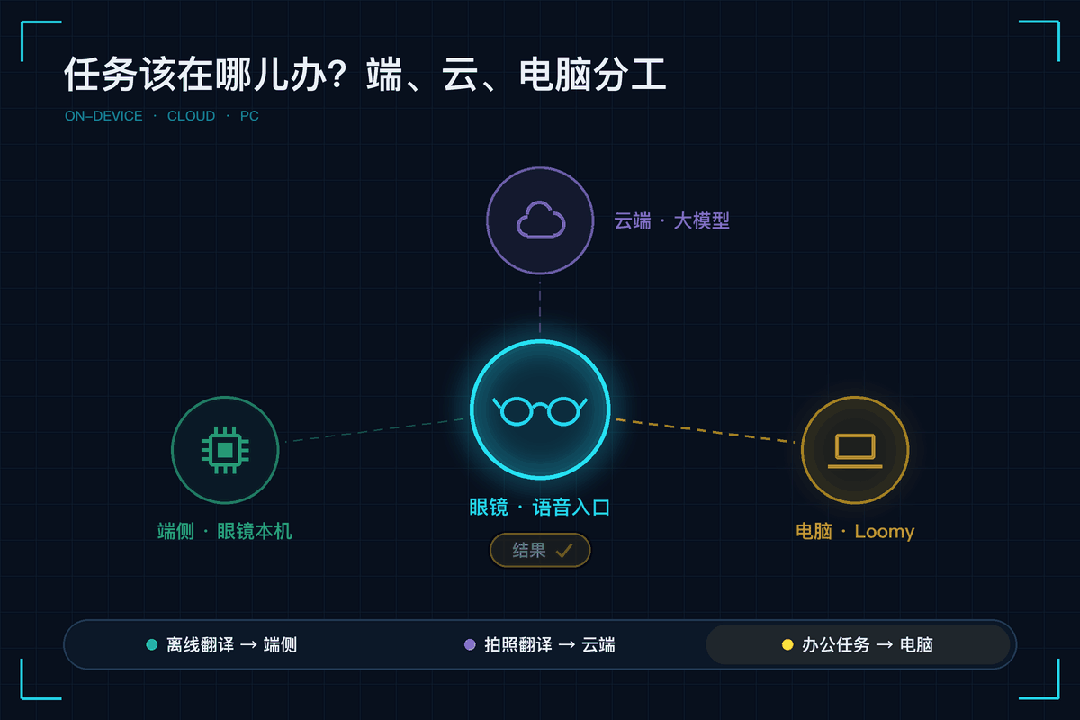
端云一体在眼镜上也有体现:离线翻译在眼镜端完成;拍照翻译、视觉问答这类复杂任务,则把照片交给云端的多模态大模型处理,再把结果送回镜片。
眼镜还能当智能体的入口。通过GlassClaw(眼镜端的智能体调度模式),可以联动Loomy(讯飞的跨端办公智能体),开口交代任务,由电脑在后台执行,比如把会议录音和现场照片整理成图文纪要。
如下图所示,为眼镜、云端和电脑之间的任务分工:
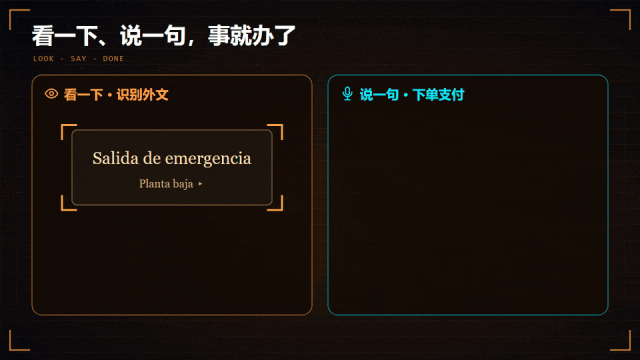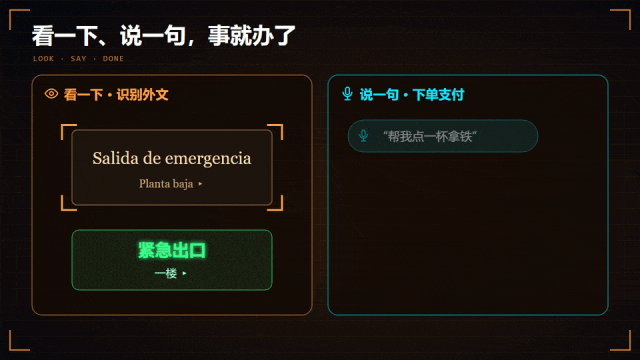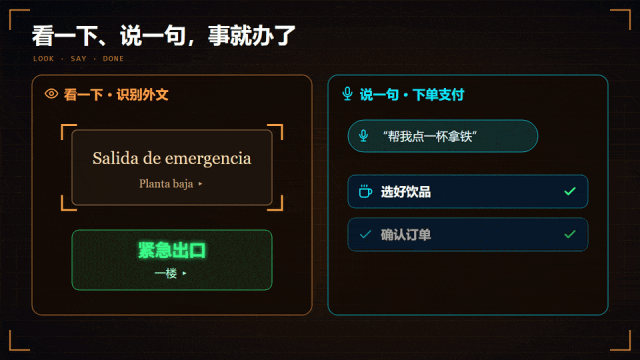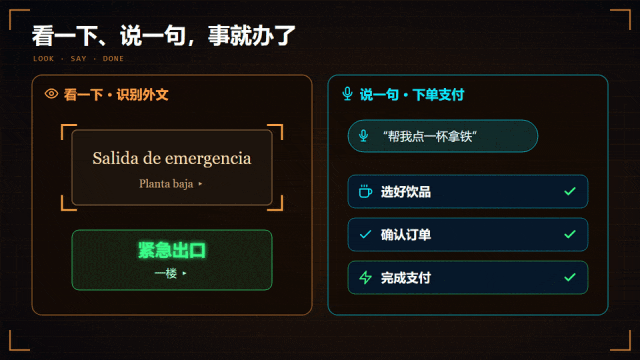
生活服务也接进来了:出门看不懂外文,可以唤醒AI助手“小飞”识别解读;想喝咖啡,说一句话就能完成下单和支付。
如下图所示,为眼镜接入的生活服务场景:
整体来看,讯飞做眼镜不是追一个热门品类,而是把自己在语音、多模态和端云协同上的积累,落到一个离人最近的硬件上。
最后总结一下
如下图所示,一张图看懂讯飞AI眼镜的完整技术链路:
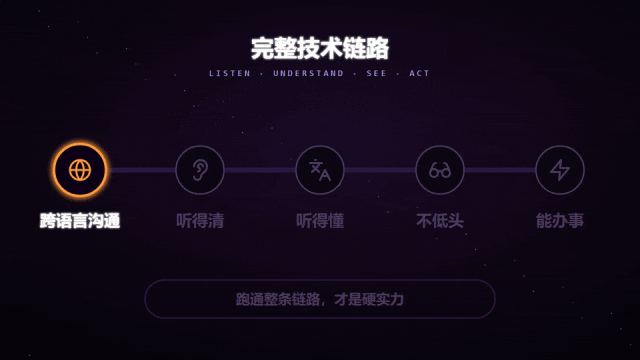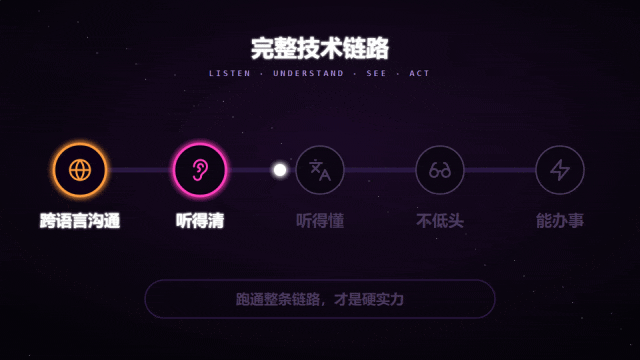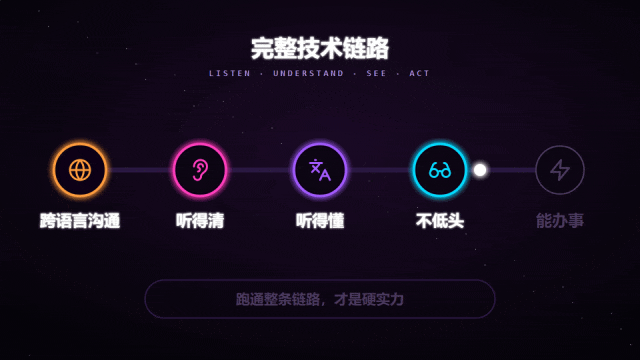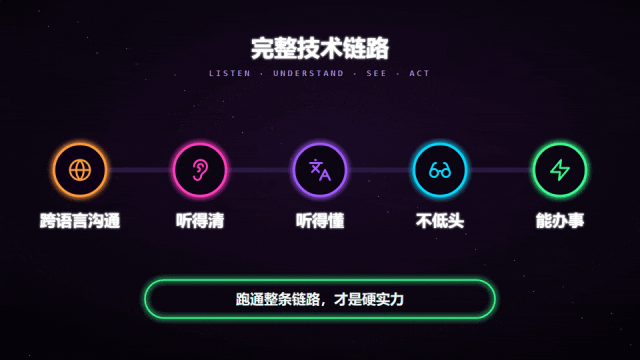
这次拆下来,我最大的感受是:AI眼镜比的不是单项参数,而是能不能在几十克里跑通“听清、听懂、看见”整条链路。
讯飞每一环都有自己的技术积累,又先从跨语言沟通这个刚需切入,这和它在1024上展示的教育、医疗、法律等落地思路一脉相承:先抓刚需,再做规模,让AI的价值在真实使用中被验证。
对于经常出差、开国际会议、和海外客户打交道的人来说,这类眼镜的意义非常直接:交流时不用再低头。
常见问题
戴上这副AI眼镜,外国人的话直接变成眼前的字幕,太夯了!测了什么?
看 AI消息 的实际效果、使用门槛和结果表现。
戴上这副AI眼镜,外国人的话直接变成眼前的字幕,太夯了!适合谁看?
适合正在选工具、做本地部署或验证 AI 工作流的人。
戴上这副AI眼镜,外国人的话直接变成眼前的字幕,太夯了!要注意什么?
重点看配置成本、失败点、数据边界和可替代方案。
相关内容